System calls: dins del kernel
Com transforma Linux una petició d’usuari en una operació segura?
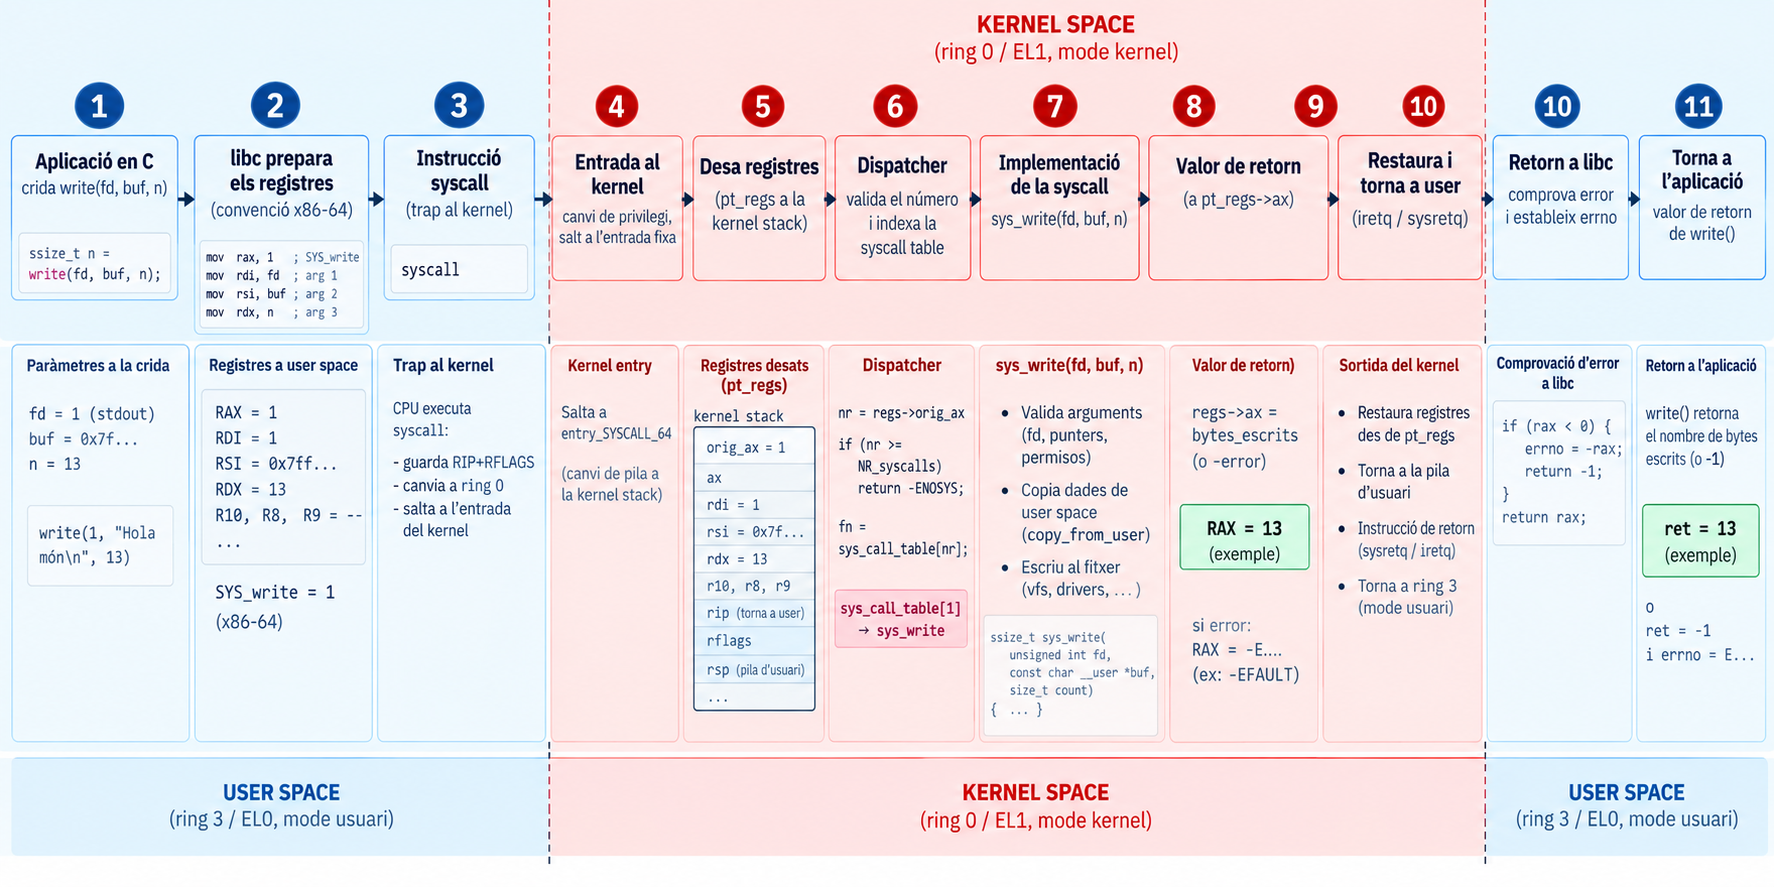
Què fa el punt d’entrada?
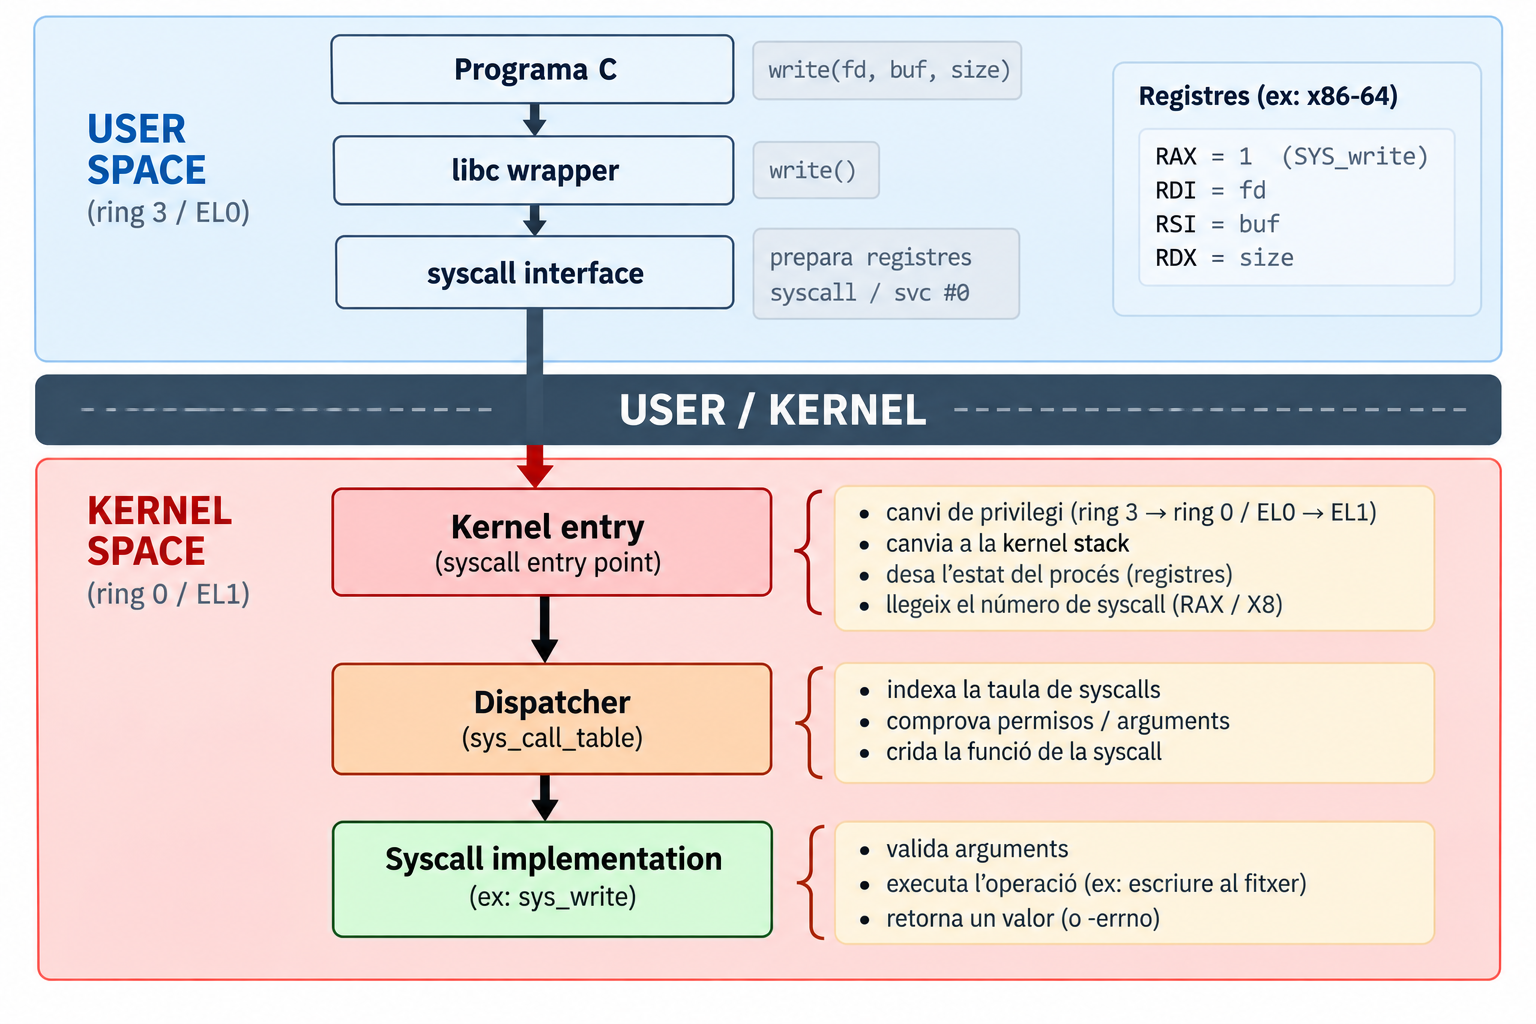
- La instrucció
syscall/svcfa el mínim: privilegi + salt a l’entrada fixa. - El codi d’entrada del kernel fa la resta: canvia de pila i desa l’estat d’usuari.
Una syscall no és simplement canviar de stack: l’entrada al kernel prepara l’execució sobre la kernel stack i deixa desat tot el que cal per tornar.
User stack i kernel stack
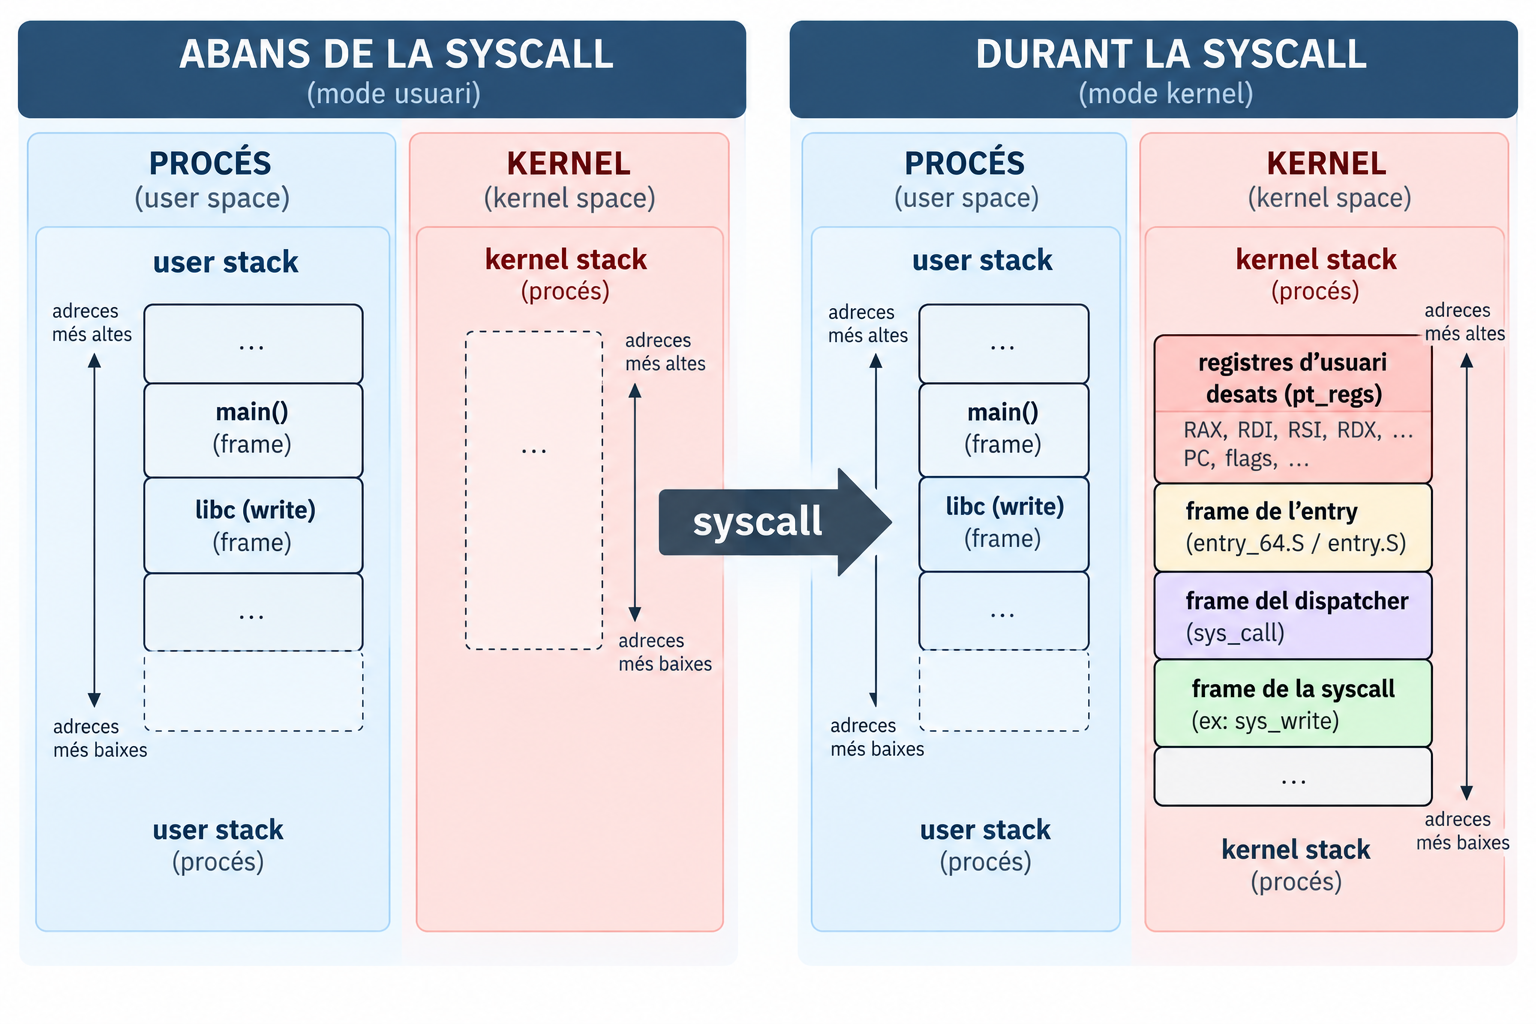
- El kernel no pot confiar en el
SPd’usuari (podria apuntar a qualsevol lloc): usa la seva pila, una per fil/tasca. - x86-64:
syscallno canviaRSP; el codi d’entrada ho fa a mà. - ARM64: cada nivell té el seu registre de pila (
SP_EL0/SP_EL1).
Què es desa? · struct pt_regs
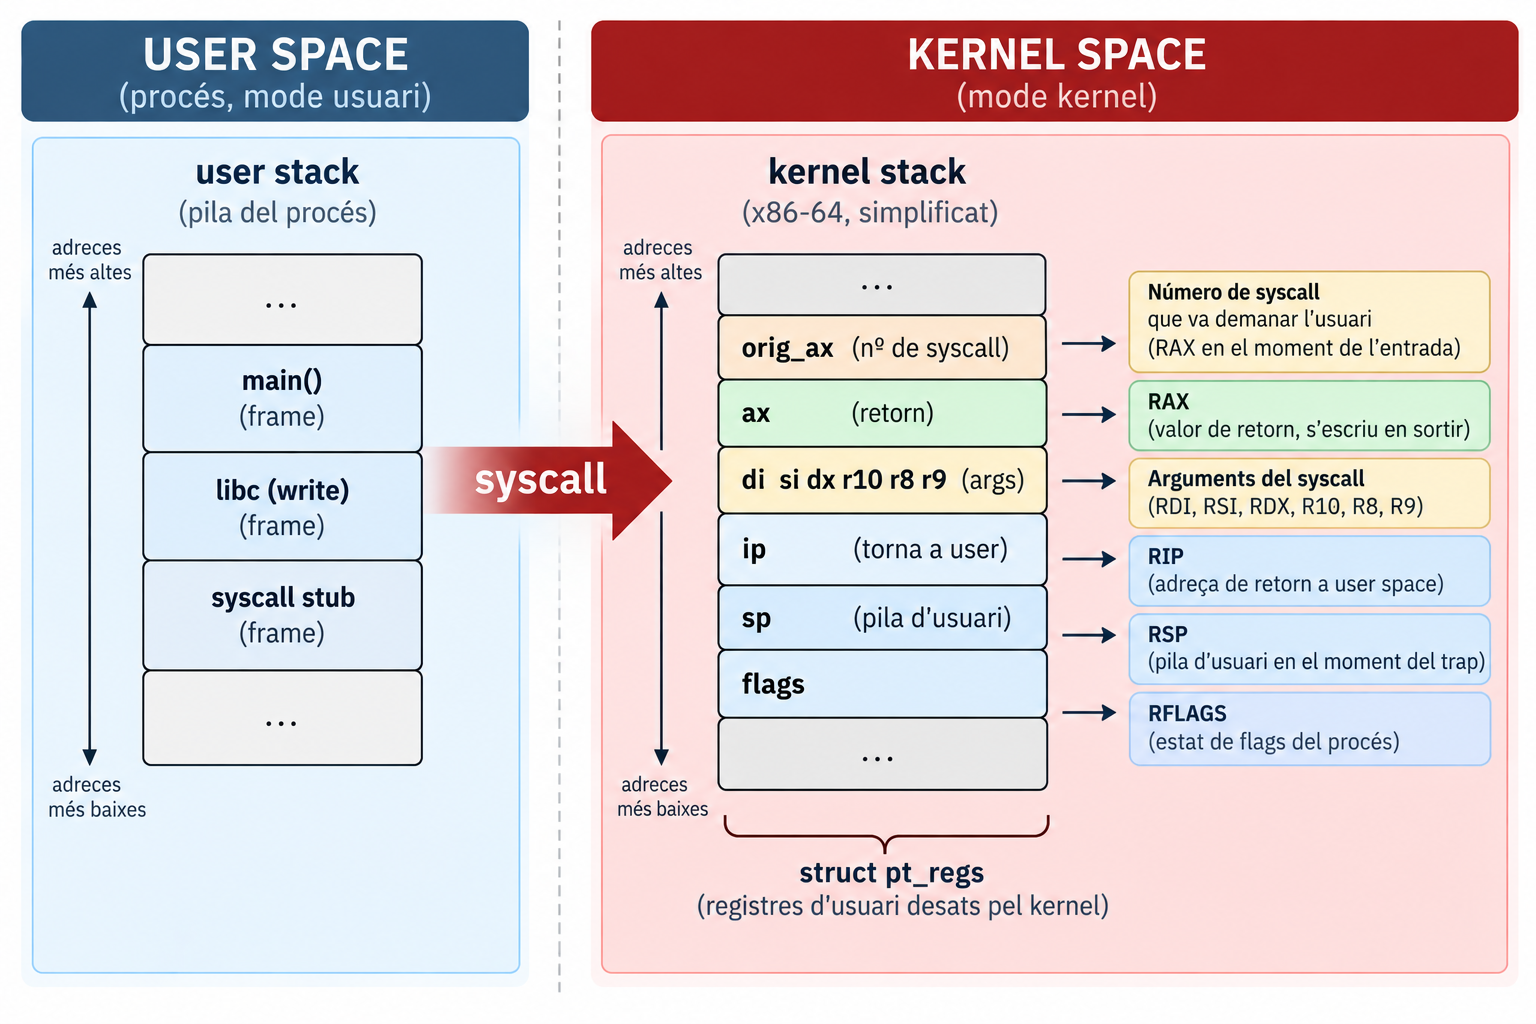
- Linux desa els registres a una estructura
struct pt_regs, a la kernel stack. - El dispatcher llegeix el número de
orig_axi els arguments dels camps delpt_regs. - El resultat s’escriu a
regs->ax; en tornar, es restaura tot. - Cada arquitectura té el seu
pt_regs.
Cada procés veu el seu espai d’adreces
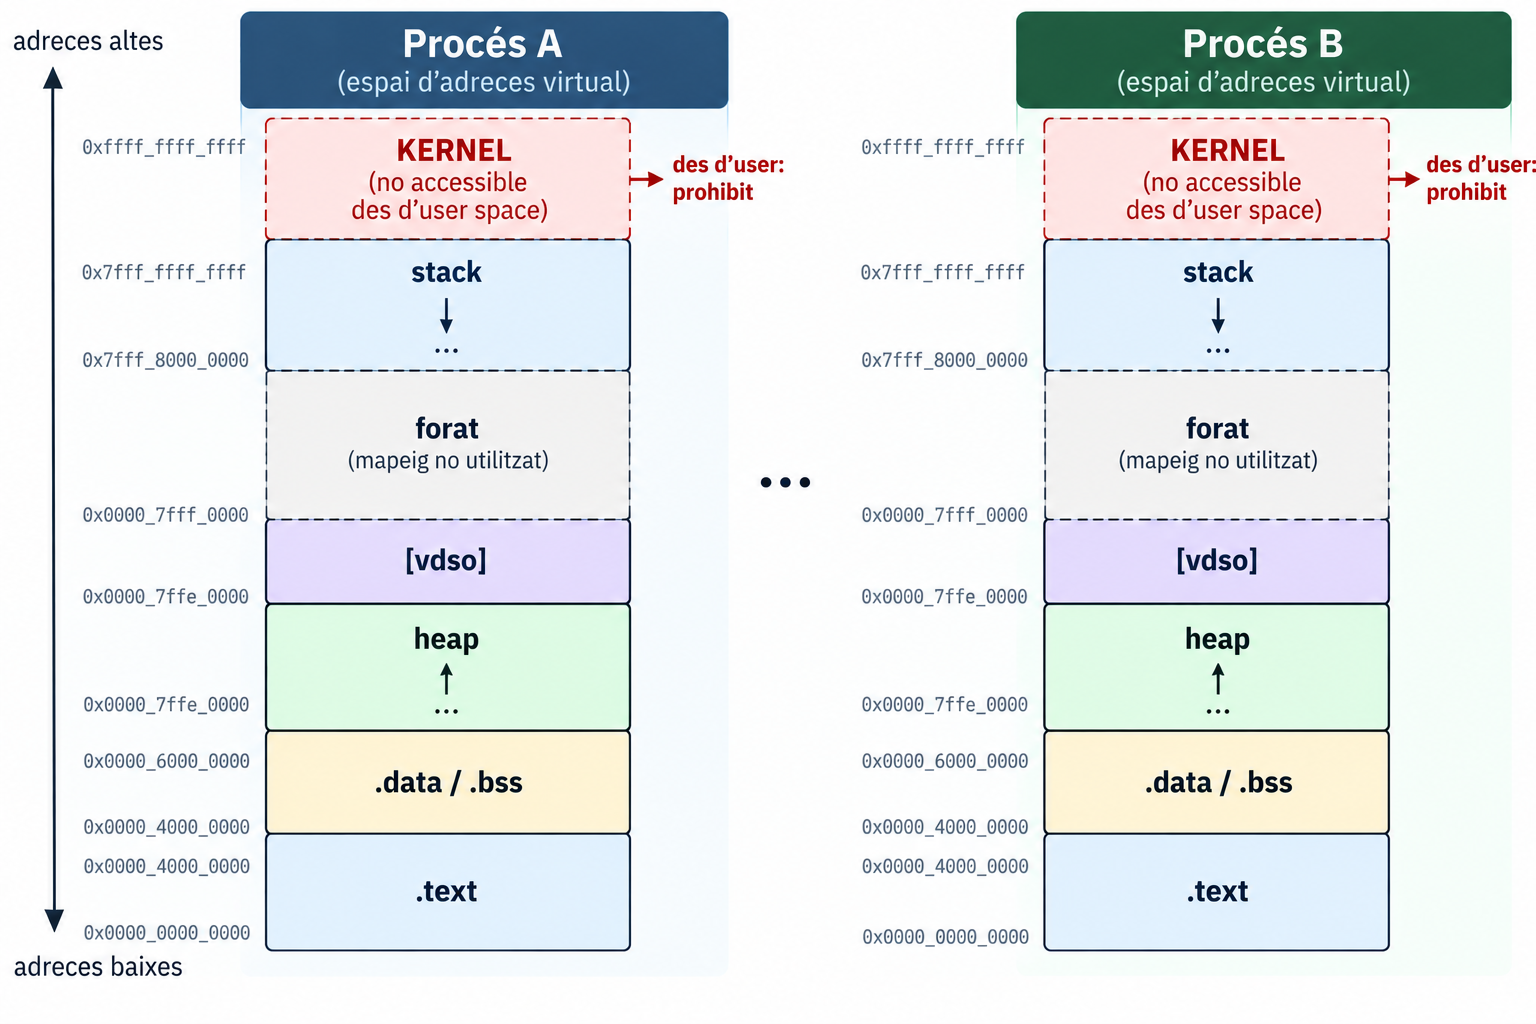
- Les adreces que veu el programa són virtuals: la CPU (MMU) les tradueix a memòria física amb l’ajuda del kernel.
- Dos processos poden usar la mateixa adreça virtual i veure dades diferents.
- La part alta és del kernel: un programa d’usuari no pot accedir-hi.
Page fault: dues sortides
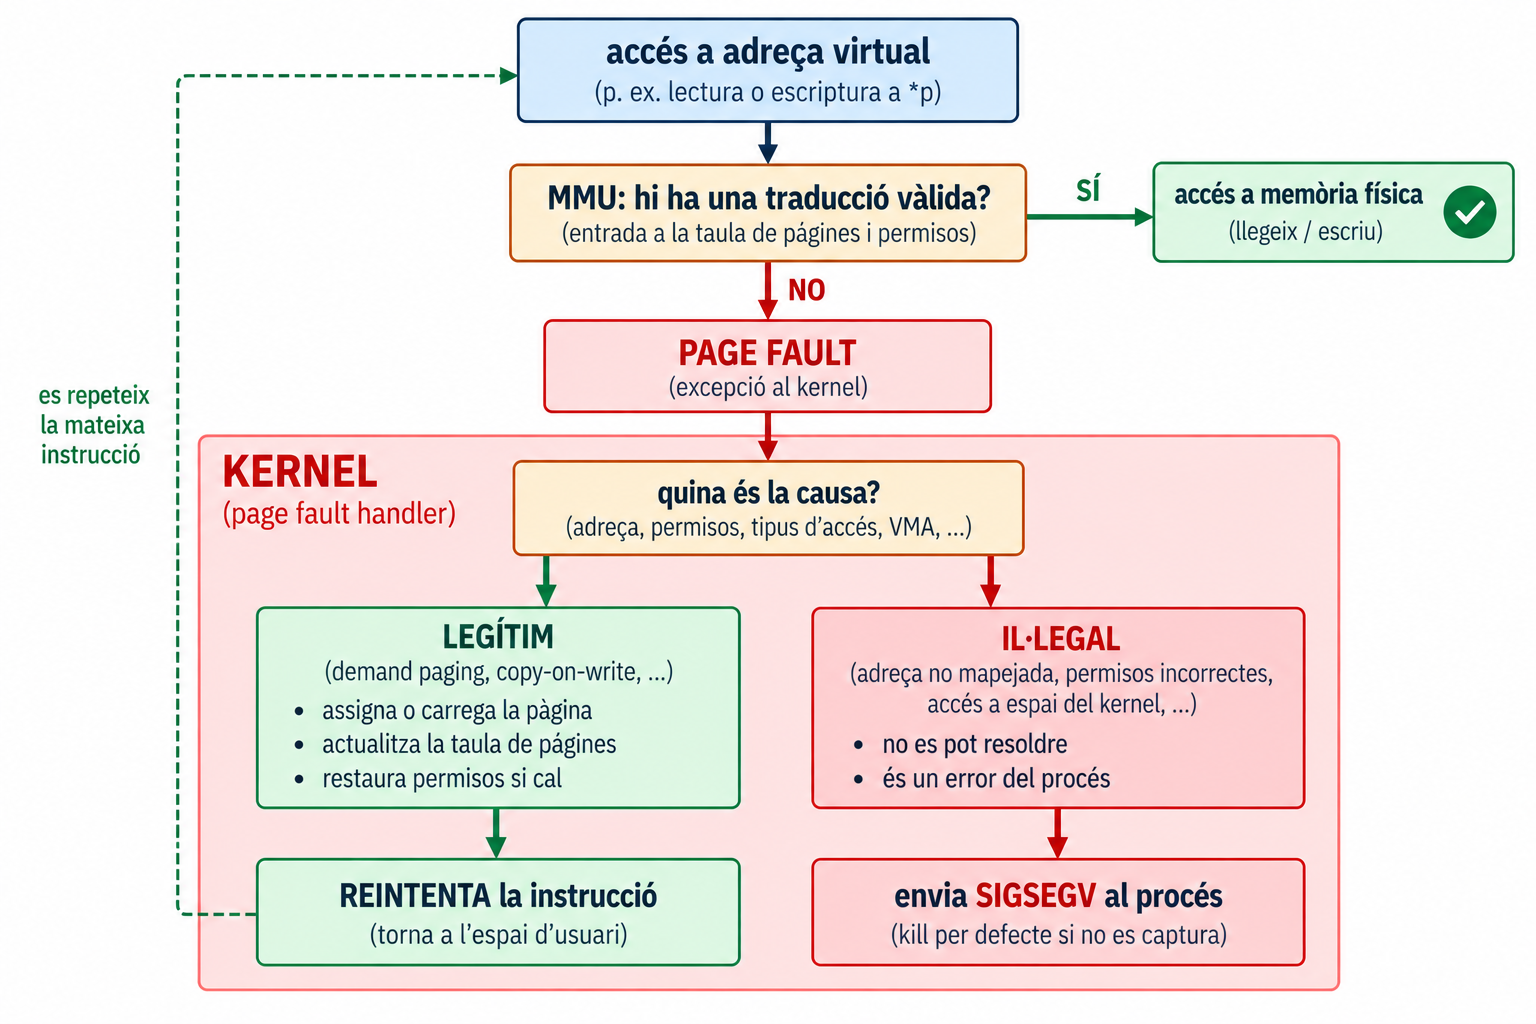
Un page fault no és necessàriament un error: és un mecanisme normal. El que decideix si és un error és el kernel, segons l’espai d’adreces del procés.
Com sap Linux quina operació ha de fer?
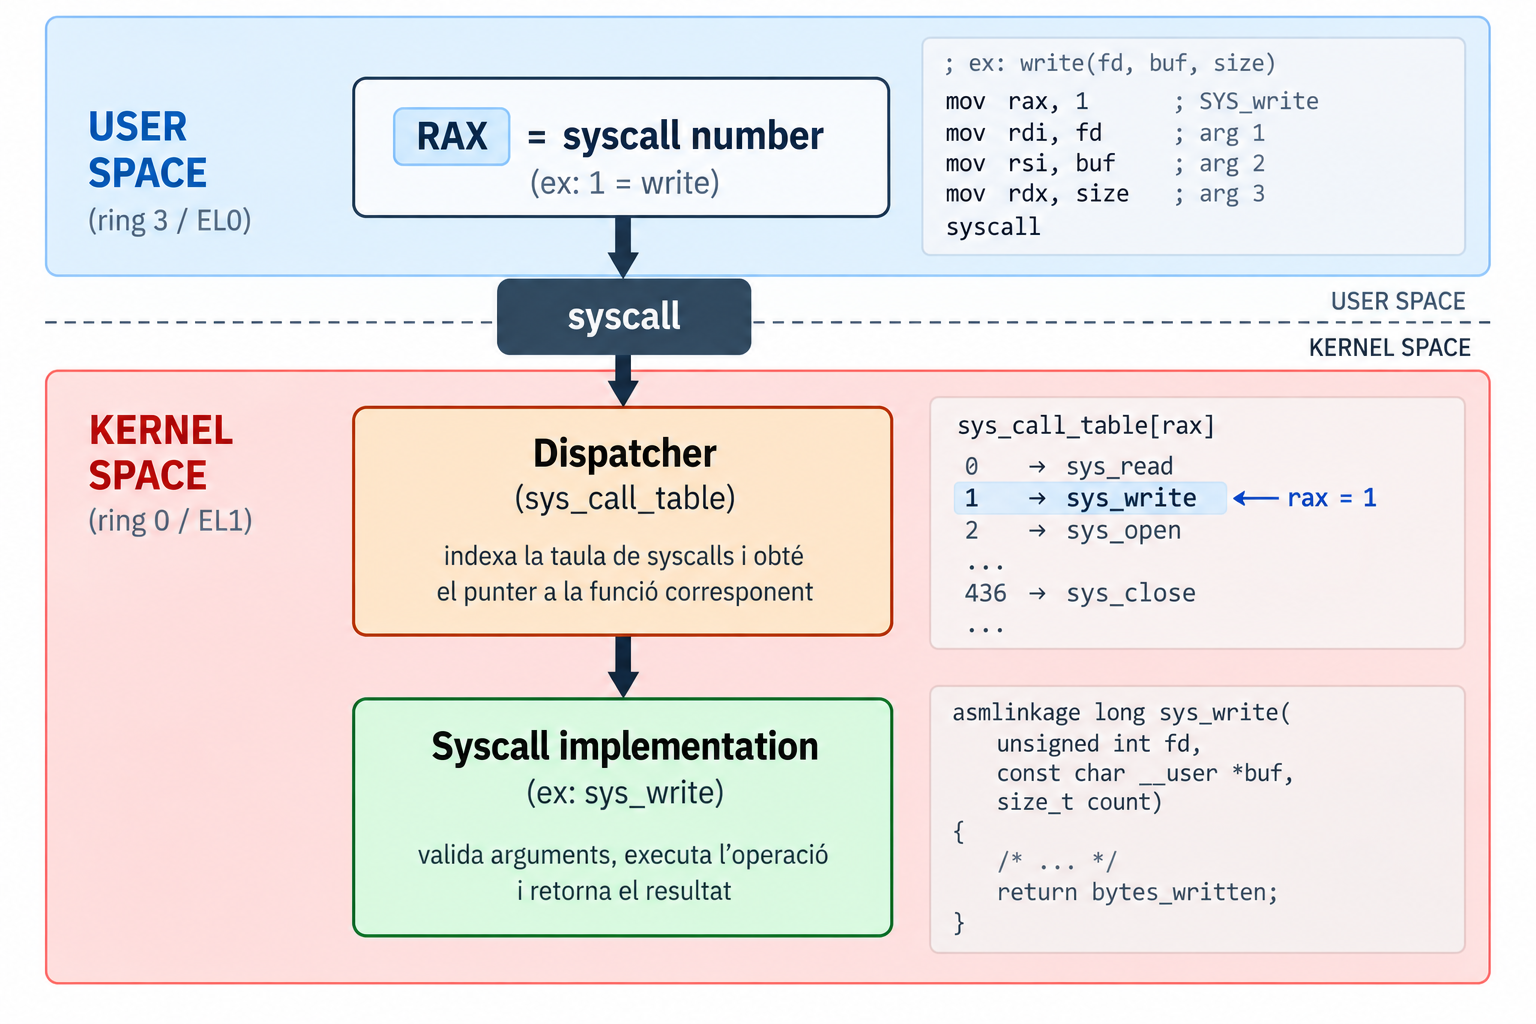
Quina funció del kernel s’executa? I si el número no existeix?
Syscall table (model conceptual)
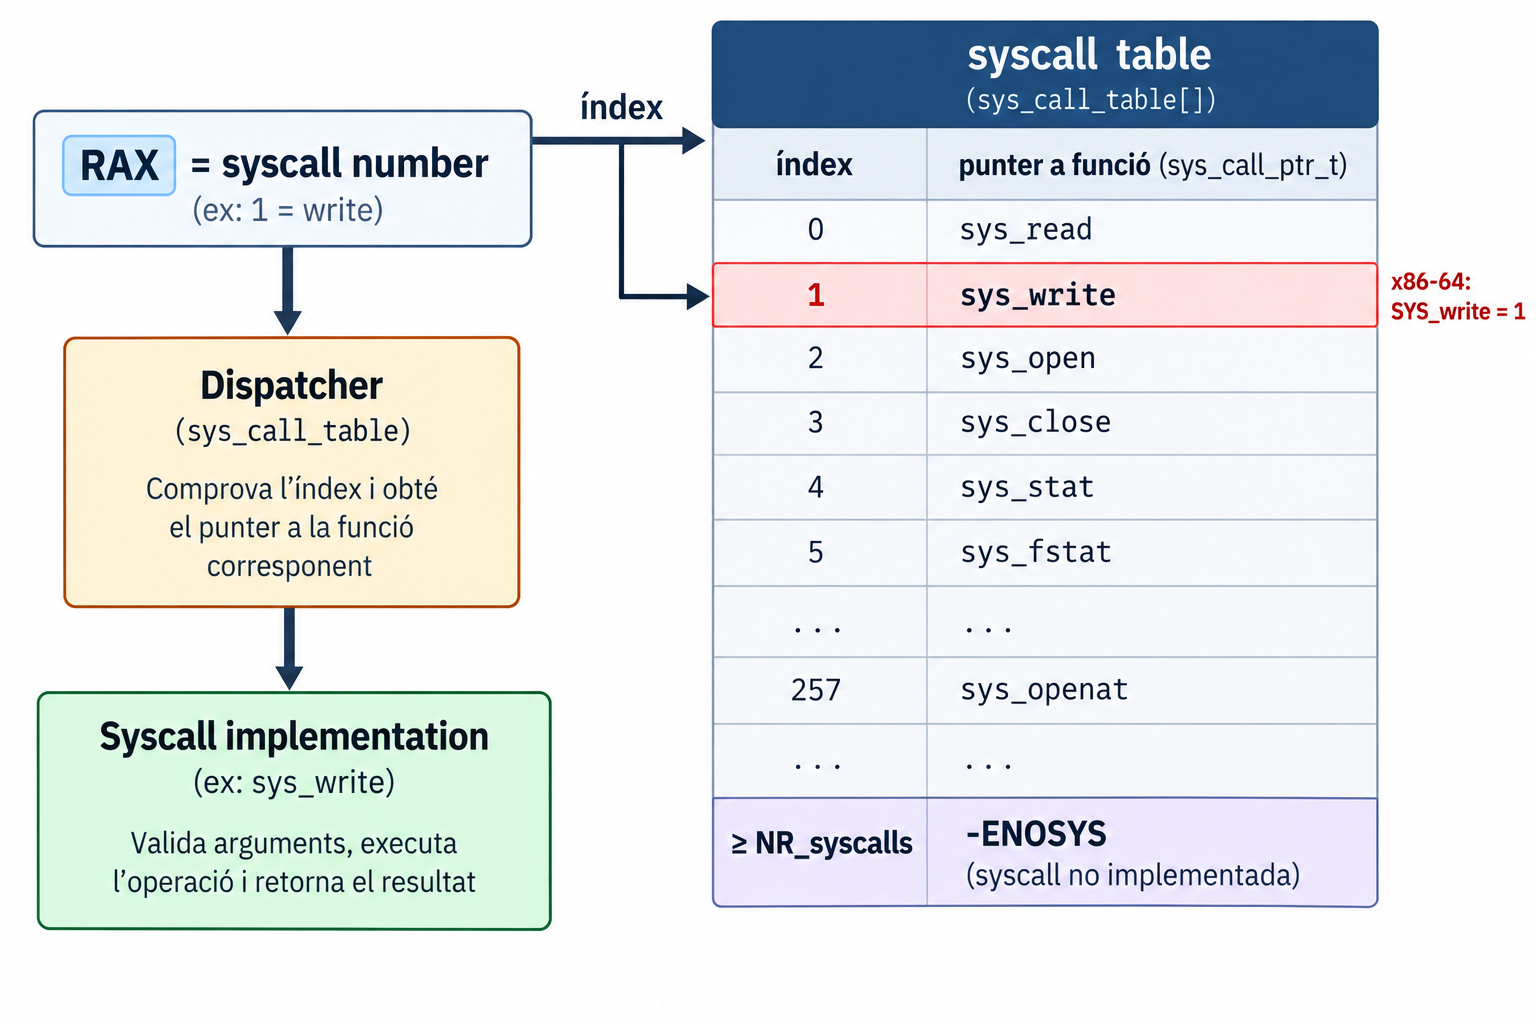
La idea número → funció del kernel és sempre la mateixa. La implementació concreta depèn de l’arquitectura i de la versió del kernel (taula, switch…).
- Les taules són diferents per arquitectura (a ARM64:
read= 63,write= 64,openat= 56). - Un número fora de rang →
-ENOSYS.
El camí complet
Quatre casos
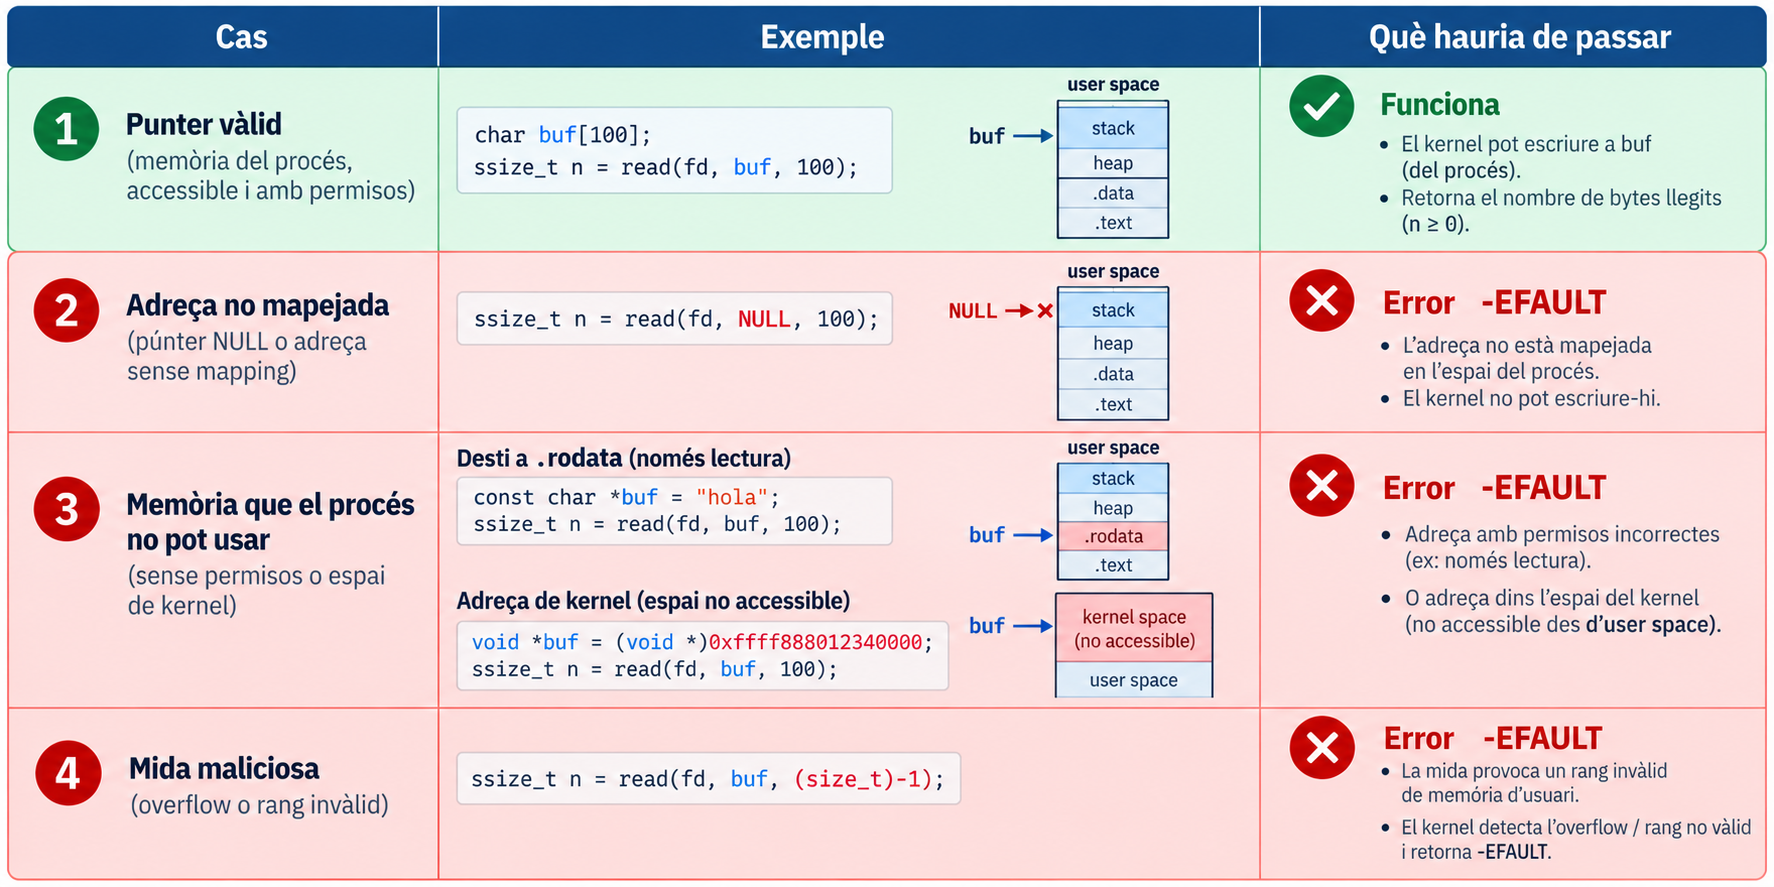
Es valida el rang [ptr, ptr + size) i els permisos, no només ptr. Amb la mateixa lògica: fd, flags, mides…
Què podria passar?
memcpy(kernel_buffer, user_ptr, size);
/* HIPOTÈTIC: cap validació */Si el kernel tractés un valor controlat per l’usuari com una adreça de memòria privilegiada, sense validar-lo, podria exposar o corrompre dades del kernel.
Exposició (model): el kernel llegeix d’una adreça que no és de l’usuari i ho envia cap a fora (p. ex. a un fitxer).
Corrupció (model): el kernel escriu en una adreça que no és de l’usuari amb dades que l’usuari controla.
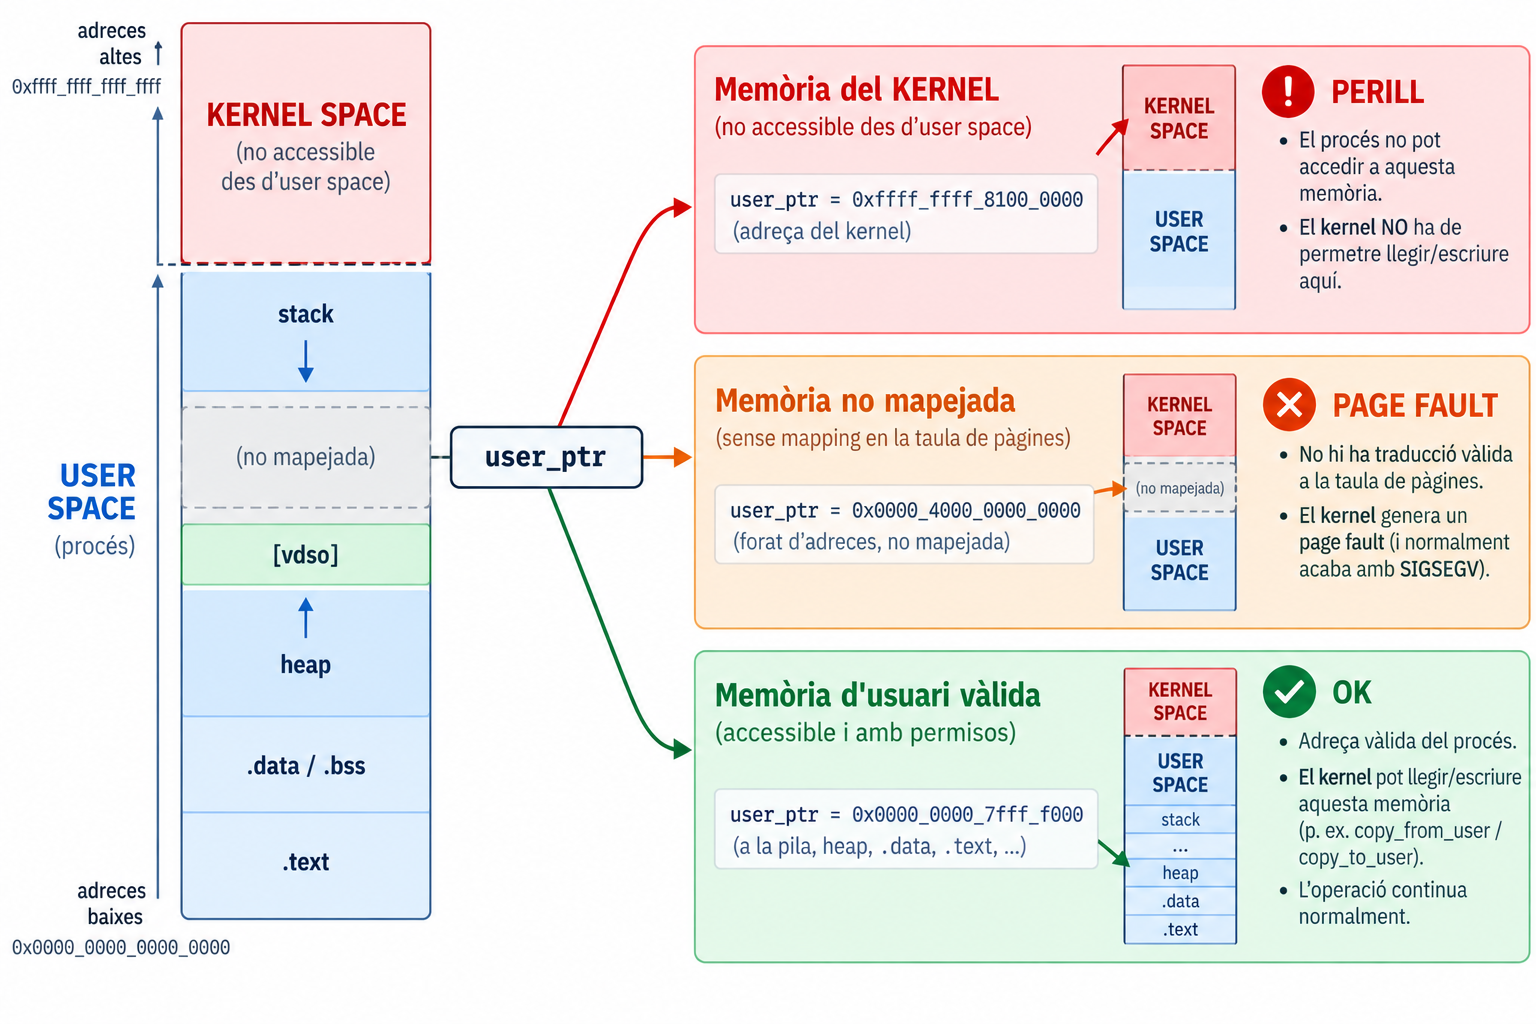
El problema no és només un segfault: el kernel actua amb els seus privilegis en nom d’un programa que no en té.
Com sap el kernel qui ha fallat?
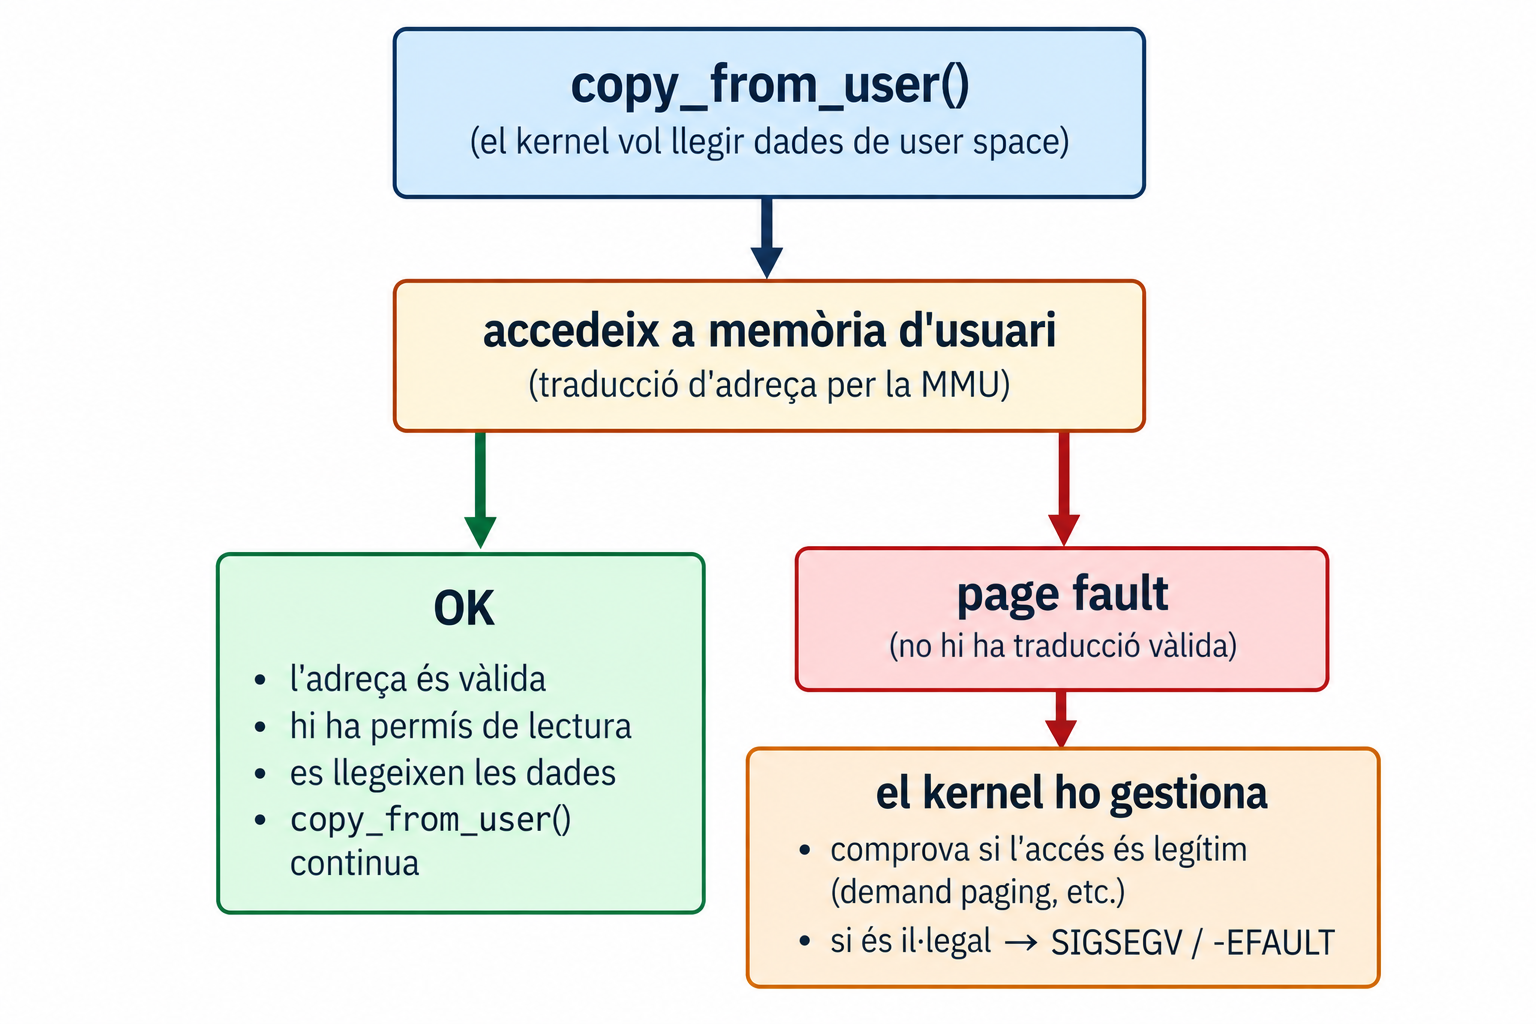
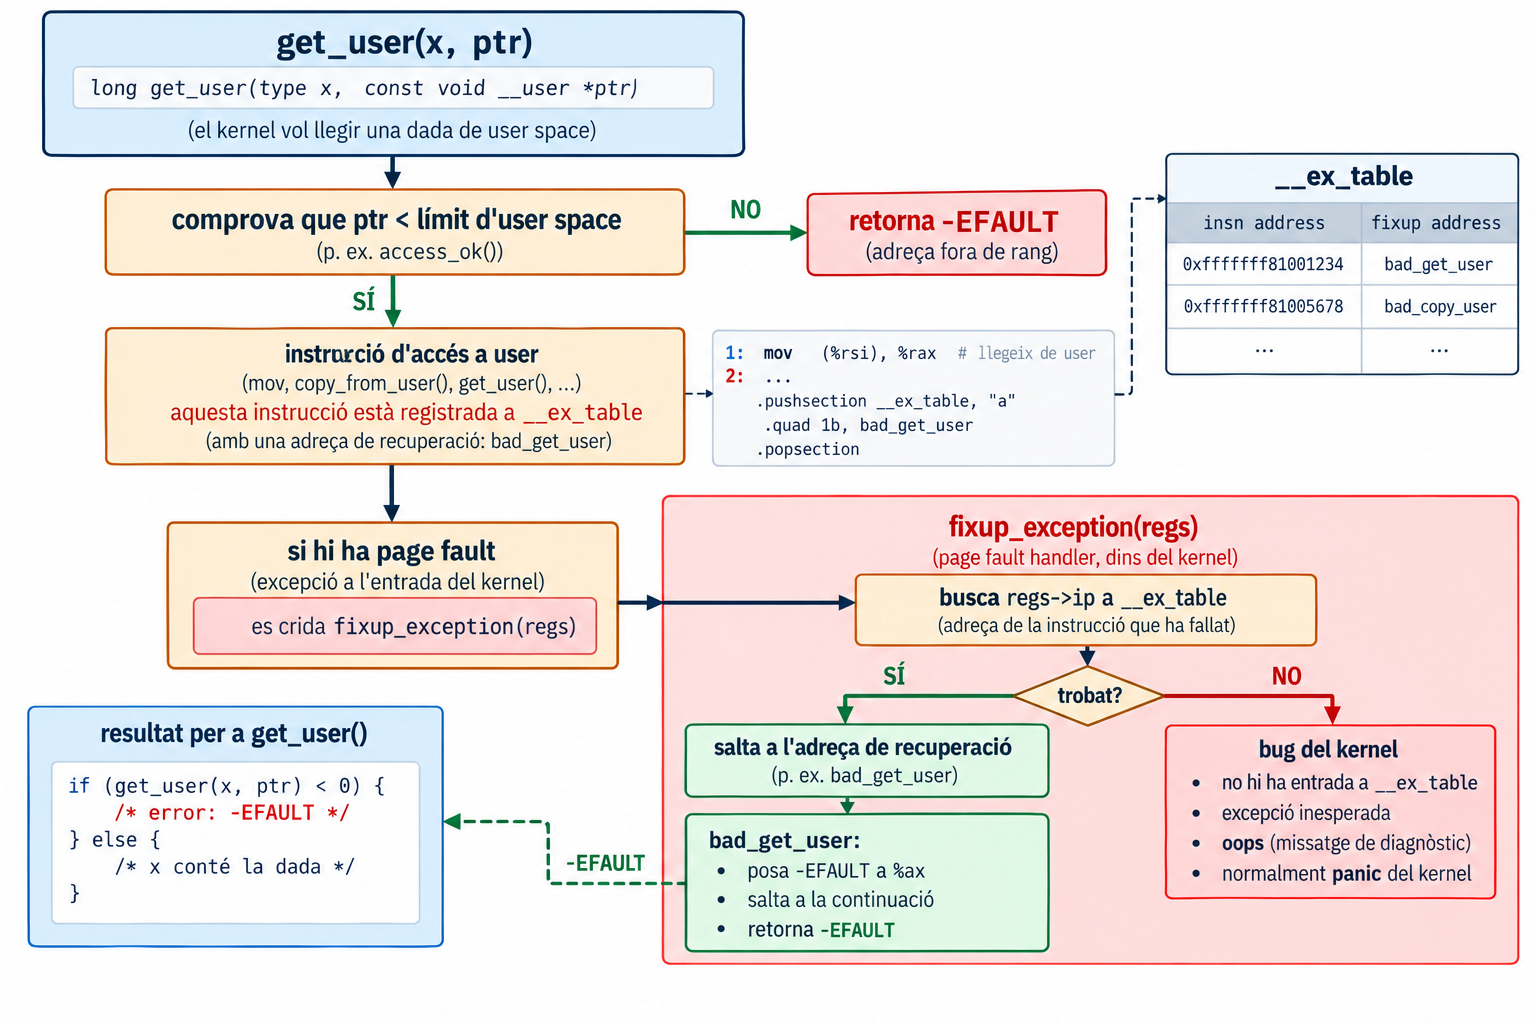
Dins del kernel, un page fault pot ser: (1) un fault legítim (demand paging), (2) un punter invàlid d’usuari, (3) un bug del kernel. Com sap el kernel què és?
- Cas 1: l’adreça és d’user i vàlida per al procés → el kernel la resol.
- Casos 2 i 3: l’adreça d’user és invàlida i la instrucció que falla és del kernel. Són indistingibles per l’adreça.
La solució de Linux: la taula d’excepcions
Llista de les instruccions concretes del kernel que poden accedir a memòria d’usuari (les de copy_from_user, get_user…), amb l’adreça on recuperar-se si fallen.
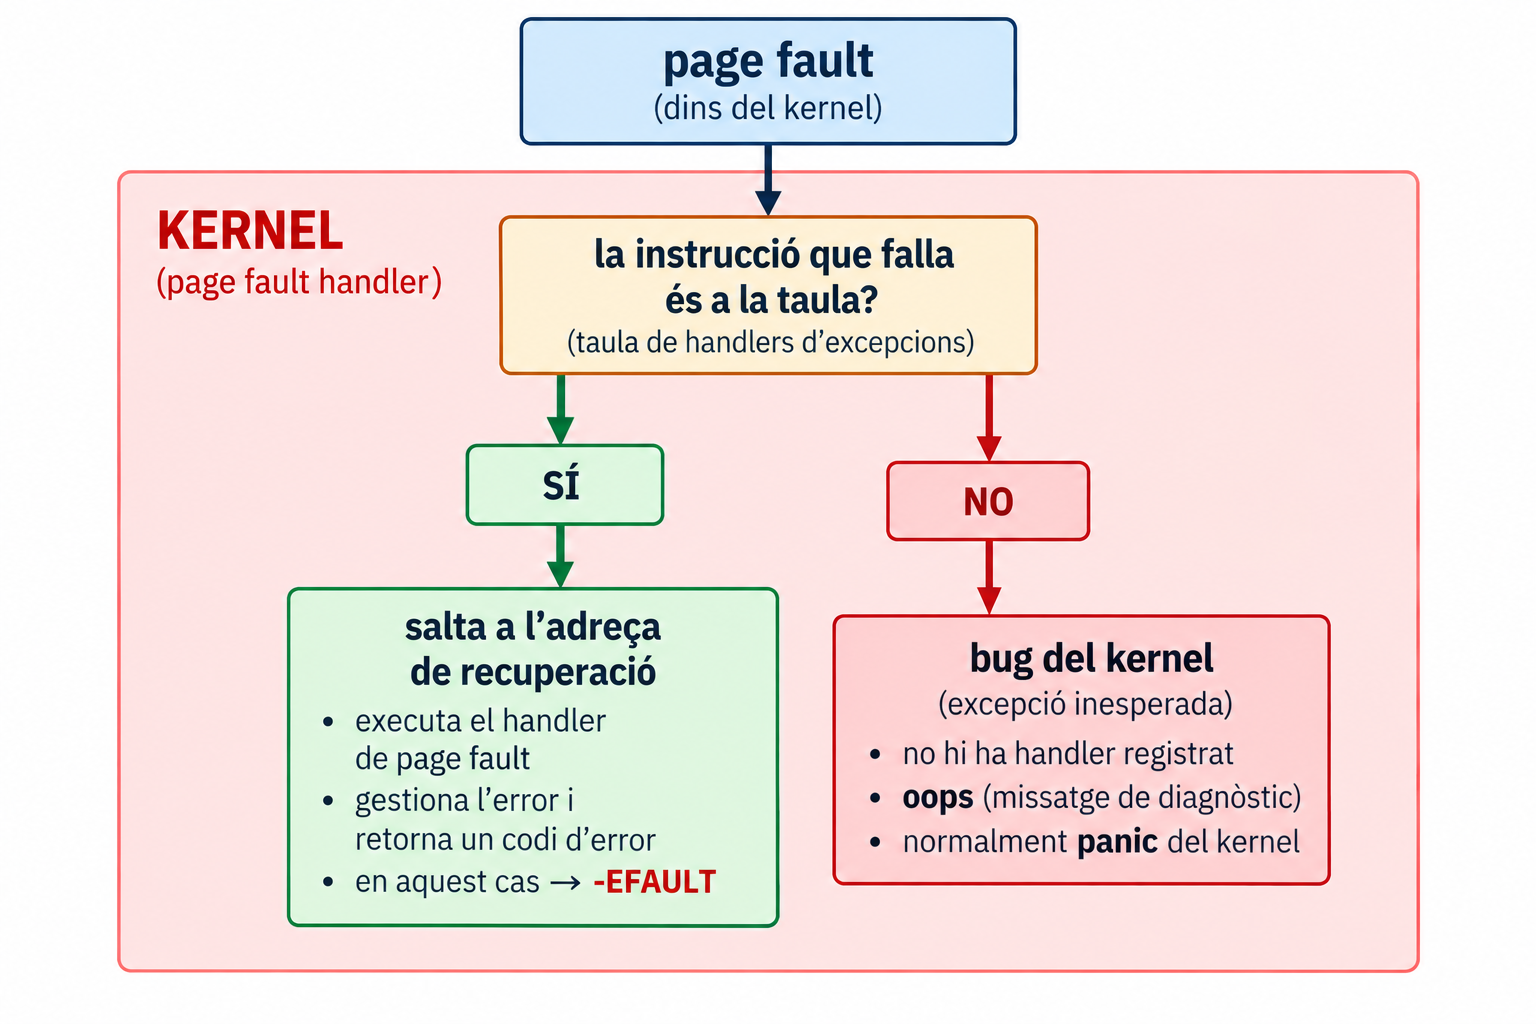
Resultat: un accés invàlid a memòria d’usuari es converteix en un -EFAULT i no en un crash del kernel.
Una syscall també retorna informació
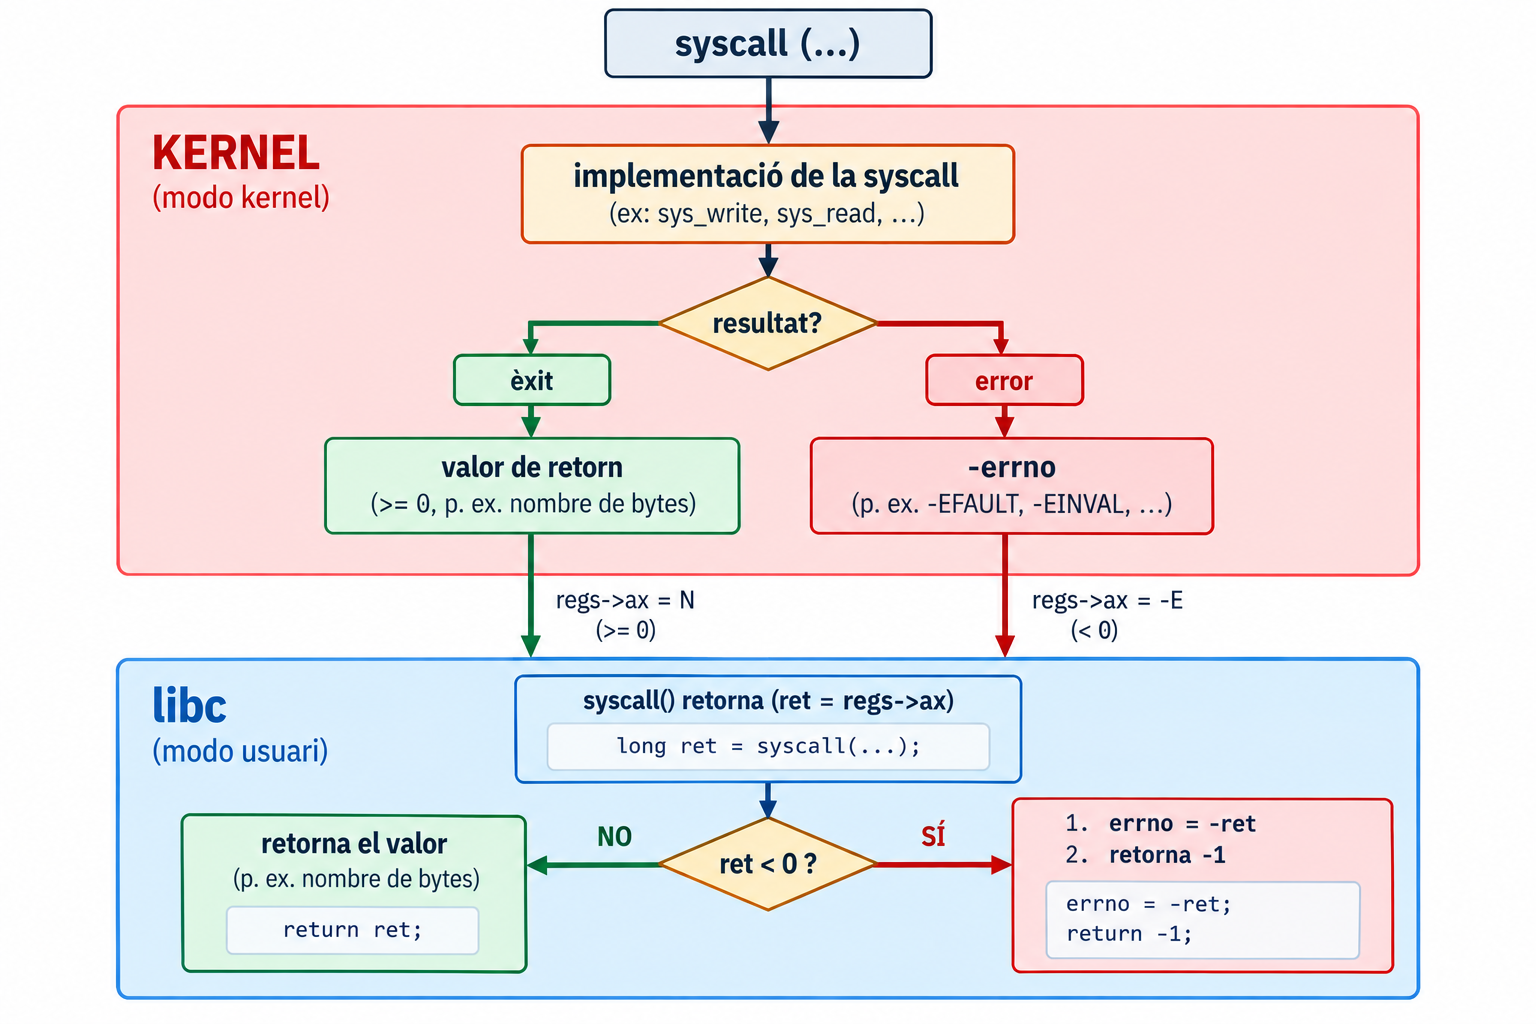
ssize_t n = write(fd, buf, len);- Èxit → nombre de bytes.
- Error →
-1ierrnoamb el motiu.
El kernel retorna un valor negatiu (-errno, dins del rang -4095..-1) al registre de retorn. El wrapper de libc el converteix: errno = -ret; return -1;.
errno no és una variable que el kernel retorni: és una variable de la libc (per fil) que omple el wrapper.
Annex B · get_user i la taula d’excepcions